

[2025年07月24日] 最新Microsoft Certified DP-600日本語実際の無料試験解答
Microsoft Certified DP-600日本語問題集最新の練習テスト190独特な解答
質問 # 100
研究部門のデータ分析要件を満たすファブリック容量 SKU のタイプを推奨する必要があります。何を推奨すればよいでしょうか?
- A. P
- B. A
- C. F
- D. EM
正解:C
質問 # 101
注: この質問は、同じシナリオを提示する一連の質問の一部です。一連の質問にはそれぞれ、定められた目標を満たす独自の解決策が含まれています。質問セットによっては、正しい解決策が複数ある場合もあれば、正しい解決策がない場合もあります。
このセクションで質問に答えた後は、そのセクションに戻ることはできません。そのため、これらの質問はレビュー画面に表示されません。
OneLake に新しいセマンティック モデルを含む Fabric テナントがあります。
Fabric ノートブックを使用して、データを Spark DataFrame に読み込みます。
すべての文字列列と数値列の最小値、最大値、平均値、標準偏差値を計算するために、データを評価する必要があります。
解決策: 次の PySpark 式を使用します。
df.describe().show()
これは目標を満たしていますか?
- A. はい
- B. いいえ
正解:A
解説:
https://learn.microsoft.com/en-us/dotnet/api/microsoft.spark.sql.dataframe.describe?view=spark- dotnet
質問 # 102
OneLake に新しいセマンティック モデルを含む Fabric テナントがあります。
Fabric ノートブックを使用して、データを Spark DataFrame に読み取ります。
データを評価して、すべての文字列列と数値列の最小値、最大値、平均値、標準偏差の値を計算する必要があります。
解決策: 次の PySpark 式を使用します。
df.show()
これは目標を達成していますか?
- A. いいえ
- B. はい
正解:A
解説:
The df.show() method also does not meet the goal. It is used to show the contents of the DataFrame, not to compute statistical functions. Reference = The usage of the show() function is documented in the PySpark API documentation.
質問 # 103
ケーススタディ 1 - Contoso
概要
Contoso, Ltd. は米国を拠点とする健康補助食品会社です。Contoso には、営業部門と研究部門という 2 つの部門があります。営業部門には、オンライン販売部門と小売販売部門という 2 つの部署があります。研究部門は、社内で開発された製品ラインを研究者とアナリストの個々のチームに割り当てます。
既存の環境
アイデンティティ環境
Contoso には、contoso.com という名前の Microsoft Entra テナントがあります。このテナントには、ResearchReviewersGroup1 と ResearchReviewersGroup2 という名前の 2 つのグループが含まれています。
データ環境
Contoso には次のデータ環境があります。
- 営業部門では、Microsoft Power BI Premium 機能を使用しています。
- オンライン販売部門のセマンティック モデルには、Import made を使用する Orders というファクト テーブルが含まれています。元のシステムでは、OrderID 値は注文が作成される順序を表します。
- 研究部門では、オンプレミスのサードパーティのデータ ウェアハウス製品を使用しています。
- contoso.com に対して Fabric が有効になっています。
- storage1 という名前の Azure Data Lake Storage Gen2 ストレージ アカウントには、Productline1 という名前の製品ラインの研究部門のデータが含まれています。 - データはデルタ形式です。
- storage2 という名前の Data Lake Storage Gen2 ストレージ アカウントには、Productline2 という名前の製品ラインの研究部門データが含まれています。データは CSV 形式です。
要件
計画された変更
Contoso は次の変更を行う予定です。
- 営業部門が使用する Power BI Premium 容量で Fabric のサポートを有効にします。
- 営業部門と研究部門のすべてのデータを Fabric で利用できるようにします。
- 研究部門用に、Productline1ws と Productine2ws という名前の 2 つの Fabric ワークスペースを作成します。
- Productline1ws で、Lakehouse1 という名前のレイクハウスを作成します。
- Lakehouse1 で、ResearchProduct という名前の storage1 へのショートカットを作成します。
データ分析の要件
Contoso では、次のデータ分析要件を特定しています。
- 営業部門と研究部門のすべてのワークスペースは、すべての Fabric エクスペリエンスをサポートする必要があります。
- 研究部門のワークスペースでは、分単位で課金される専用のオンデマンド容量を使用する必要があります。
- 部門名に基づいて OneLake データ ハブのフィルタリングをサポートするには、研究部門のワークスペースを論理的にグループ化する必要があります。
- 研究部門のワークスペースでは、ResearchReviewersGroup1 のメンバーは、SQL エンドポイントを使用して、レイクハウスとウェアハウスのデータおよびショートカットを読み取ることができる必要があります。
- 研究部門のワークスペースでは、ResearchReviewersGroup2 のメンバーが Lakehouse エクスプローラーを使用してレイクハウス データを読み取ることができる必要があります。
- 研究部門のすべてのセマンティック モデルとレポートでは、ブランチをサポートするバージョン管理を使用する必要があります。
データ準備の要件
Contoso では、次のデータ準備要件を特定しています。
- Productline1 の研究部門データは、Fabric ノートブックを使用して Lakehouse1 から取得する必要があります。
- レイクハウス内のすべての研究部門データは、レイクハウス エクスプローラーで管理テーブルとして表示する必要があります。
セマンティックモデルの要件
Contoso は、セマンティック モデルの実装と管理に関して次の要件を特定しています。
- 更新中に Orders テーブルに追加される行数を最小限に抑える必要があります。
- 研究部門ワークスペースのセマンティック モデルは、Direct Lake モードを使用する必要があります。
一般的な要件
Contoso は、すべてのソリューションで考慮する必要がある次の高レベルの要件を特定しています。
- 該当する場合は、最小権限の原則に従ってください。
- 可能な場合は実装と保守の労力を最小限に抑えます。
Productline1 の研究部門データにアクセスするには、ノートブックでどの構文を使用する必要がありますか?
- A. spark.read.format("delta").load("Tables/ResearchProduct")
- B. 外部テーブル(研究製品)
- C. spark.read.format("delta").load("Tables/productline1/ResearchProduct")
- D. spark.sql("Select * FROM Lakehouse1.Tables.ResearchProduct")
正解:A
解説:
This syntax correctly specifies the format as Delta and loads the data from the specified table in the lakehouse.
質問 # 104
Sales.Products という名前のテーブルを含む Fabric ウェアハウスがあります。 Sales.Products には次の列が含まれます。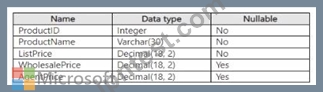
次の列を返す T-SQL クエリを作成する必要があります。
コードをどのように完成させるべきでしょうか?回答するには、回答領域で適切なオプションを選択してください。
正解:
解説: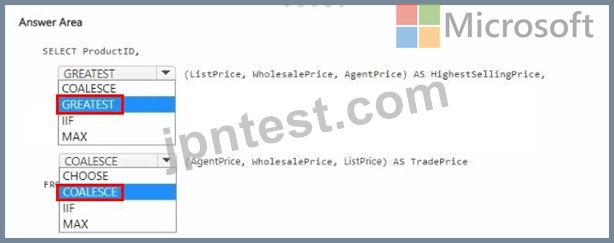
質問 # 105
モデル 1 という名前のセマンティック モデルがあります。モデル 1 には、インポート モードを使用する 5 つのテーブルが含まれています。 Model1 には、HR という名前の動的行レベル セキュリティ (RLS) ロールが含まれています。 HR ロールは従業員データをフィルタリングして、HR マネージャーが自分が割り当てられている部門のデータのみを表示できるようにします。
Model1 をファブリック テナントに公開し、RLS ロール メンバーシップを構成します。モデルと関連レポートをユーザーと共有します。
人事マネージャーは、レポートに表示されるデータが不完全であると報告しました。
HR マネージャーが確認したデータを検証するにはどうすればよいですか?
- A. 人事マネージャーに Microsoft Power Bl Desktop でレポートを開くように依頼します。
- B. HR マネージャーとしてレポートを表示するには、ロールとして「テスト」を選択します。
- C. レポート内のデータをフィルタリングして、人事部門用のフィルタの意図されたロジックと一致させます。
- D. データを HR ロールとして表示するには、[ロールとしてテスト] を選択します。
正解:D
解説:
To validate the data seen by the HR manager, you should use the 'Test as role' feature in Power BI service.
This allows you to see the data exactly as it would appear for the HR role, considering the dynamic RLS setup.
Here is how you would proceed:
* Navigate to the Power BI service and locate Model1.
* Access the dataset settings for Model1.
* Find the security/RLS settings where you configured the roles.
* Use the 'Test as role' feature to simulate the report viewing experience as the HR role.
* Review the data and the filters applied to ensure that the RLS is functioning correctly.
* If discrepancies are found, adjust the RLS expressions or the role membership as needed.
References: The 'Test as role' feature and its use for validating RLS in Power BI is covered in the Power BI documentation available on Microsoft's official documentation.
質問 # 106
Workspace1 という名前の Fabric ワークスペースと、storage"! という名前の Azure Data Lake Storage Gen2 アカウントがあります。Workspace1 には、Lakehouse1 という名前のレイクハウスが含まれています。
ストレージへのショートカットを作成する必要があります。レイクハウス1にて。
どの接続とエンドポイントを指定する必要がありますか?回答するには、回答領域で適切なオプションを選択してください。
注: 正しく選択するたびに 1 ポイントの価値があります。
正解:
解説:
Explanation:
When creating a shortcut to an Azure Data Lake Storage Gen2 account in a lakehouse, you should use the abfss (Azure Blob File System Secure) connection string and the dfs (Data Lake File System) endpoint. The abfss is used for secure access to Azure Data Lake Storage, and the dfs endpoint indicates that the Data Lake Storage Gen2 capabilities are to be used.
質問 # 107
Microsoft Power Bl セマンティック モデルがあります。
[要約] プロパティが [なし] 以外の値に設定されているモデル内のサロゲート キー列を識別する必要があります。ソリューションは労力を最小限に抑える必要があります。
何を使えばいいのでしょうか?
- A. Microsoft Power Bl デスクトップのモデル エクスプローラー
- B. Microsoft Power Bl デスクトップのモデル ビュー
- C. DAX Studio の DAX フォーマッター
- D. 表形式エディターのベスト プラクティス アナライザー
正解:D
解説:
To identify surrogate key columns with the "Summarize By" property set to a value other than "None," the Best Practice Analyzer in Tabular Editor is the most efficient tool. The Best Practice Analyzer can analyze the entire model and provide a report on all columns that do not meet a specified best practice, such as having the "Summarize By" property set correctly for surrogate key columns. Here's how you would proceed:
Open your Power BI model in Tabular Editor.
Go to the Advanced Scripting window.
Write or use an existing script that checks the "Summarize By" property of each column.
Execute the script to get a report on the surrogate key columns that do not have their "Summarize By" property set to "None".
You can then review and adjust the properties of the columns directly within the Tabular Editor.
質問 # 108
セマンティック モデルを含む Fabric テナントがあります。
モデルのオブジェクト レベル セキュリティ (OLS) を変更する必要があります。
何を使うべきでしょうか?
- A. 表形式エディタ
- B. ALM ツールキット
- C. Fabric サービス
- D. Microsoft Power BI デスクトップ
正解:A
質問 # 109
WH1 という名前のウェアハウスを含む Fabric テナントがあります。WH1 に対して次の T-SQL クエリを実行します。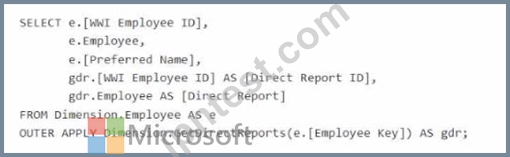
次の各文について、正しい場合は「はい」を選択してください。そうでない場合は「いいえ」を選択してください。注意: 正しい選択ごとに 1 ポイントが与えられます。
正解:
解説:
質問 # 110
あなたは、Customers と Products という名前の 2 つのディメンション テーブルを Fabric ウェアハウスに実装しています。
データのバージョン管理を管理するには、緩やかに変化するディメンション (SCO) を使用する必要があります。ソリューションは、次の表に示す要件を満たす必要があります。
各テーブルにはどのタイプの SCD を使用する必要がありますか?答えるには、適切な SCD タイプを正しいテーブルにドラッグします。各 SCD タイプは、1 回使用することも、複数回使用することも、まったく使用しないこともできます。コンテンツを表示するには、ペイン間で分割バーをドラッグするか、スクロールする必要がある場合があります。
注: 正しく選択するたびに 1 ポイントの価値があります。
正解:
解説:
質問 # 111
ホットスポットに関する質問
次の T-SQL ステートメントがあります。
次の各文について、正しい場合は「はい」を選択してください。そうでない場合は「いいえ」を選択してください。
注意: 正しい選択ごとに 1 ポイントが付与されます。
正解:
解説:
質問 # 112
注: このセクションには、同じシナリオと問題に関する 1 つ以上の質問セットが含まれています。各質問には、問題に対する独自の解決策が提示されています。解決策が規定の目標を満たしているかどうかを判断する必要があります。セット内の複数の解決策が問題を解決できる場合があります。また、セット内のどの解決策も問題を解決できない可能性もあります。
このセクションの質問に回答した後は、戻ることはできません。そのため、これらの質問はレビュー画面に表示されません。
ネットワークには、Microsoft Entra Connect を使用して Microsoft Entra テナントと同期する、contoso.com という名前のオンプレミスの Active Directory ドメイン サービス (AD DS) ドメインが含まれています。
セマンティック モデルを含む Fabric テナントがあります。
モードの動的行レベル セキュリティ (RLS) を有効にし、モデルを Fabric サービスにデプロイします。
username() 関数を含むメジャーをクエリすると、クエリによって空白の結果が返されます。
メジャーがユーザーのユーザー プリンシパル名 (UPNJ) を返すことを確認する必要があります。
解決策: Microsoft Entra Connect の同期オブジェクトのリストにユーザー オブジェクトを追加します。
これは目標を満たしていますか?
- A. いいえ
- B. はい
正解:A
質問 # 113
2 つのレイクハウスを含むファブリック テナントがあります。
湖畔からのデータを結合するデータフローを構築しています。データフロー内のクエリの 1 つから適用されるステップを次の図に示します。
ドロップダウン メニューを使用して、図に示されている情報に基づいて各ステートメントを完成させる回答の選択肢を選択します。注: 正しく選択するたびに 1 ポイントの価値があります。
正解:
解説:
Explanation: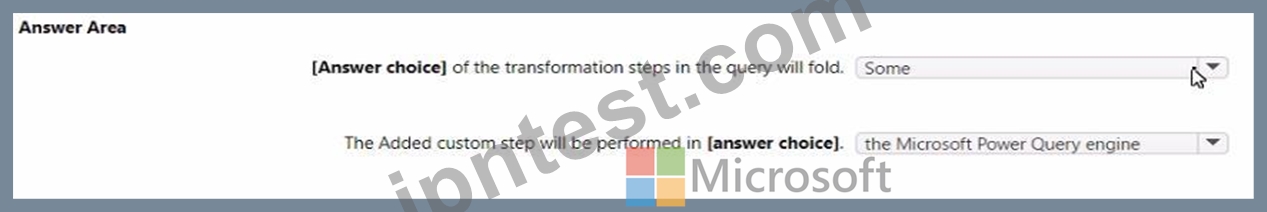
Folding in Power Query refers to operations that can be translated into source queries. In this case, "some" of the steps can be folded, which means that some transformations will be executed at the data source level. The steps that cannot be folded will be executed within the Power Query engine. Custom steps, especially those that are not standard query operations, are usually executed within Power Query engine rather than being pushed down to the source system.
References =
* Query folding in Power Query
* Power Query M formula language
質問 # 114
セマンティック モデルを含む Microsoft Power BI Premium Per User (PPU) ワークスペースがあります。
XMLA エンドポイントを使用してモデルの行レベル セキュリティ (RLS) を変更する、App1 という名前の Azure App Service アプリがあります。
App1 では、XMLA エンドポイントにアクセスするために、ユーザーは Microsoft Entra 資格情報を使用してサインインする必要があります。
モデルにアクセスするには、サービス アカウントを使用するように App1 を構成する必要があります。
まず何をすべきでしょうか?
- A. ワークスペースを Premium 容量にアップグレードします。
- B. ワークスペースにマネージド ID を追加します。
- C. XMLA エンドポイント設定を変更します。
- D. マネージド ID を App1 に追加します。
正解:D
解説:
Adding a managed identity to App1 will allow it to authenticate and access resources securely without needing to manage credentials explicitly. This is the first step in configuring the app to use a service account for accessing the model via the XMLA endpoint.
質問 # 115
Repo1 という名前の Azure Repos Git リポジトリと、ファブリック対応の Microsoft Power Bl Premium 容量があります。この容量には、「Workspace!」という名前の 2 つのワークスペースが含まれています。とワークスペース2。 Git 統合はワークスペース レベルで有効になります。
Microsoft Power Bl デスクトップとワークスペースを使用する予定です。 Repo1 に保存されているセマンティック モデルにバージョン管理された変更を加えます。変更は、Azure Pipelines を使用して Workspace2 に構築およびデプロイされます。
レポートとセマンティック モデルの定義がフォルダー階層内の個別のテキスト ファイルとして保存されていることを確認する必要があります。ソリューションでは、開発とメンテナンスの労力を最小限に抑える必要があります。
どのファイル形式で変更を保存する必要がありますか?
- A. PBIP
- B. PBIX
- C. PBIDS
- D. PBIT
正解:B
解説:
When working with Power BI Desktop and Git integration for version control, report and semantic model definitions should be saved in the PBIX format. PBIX is the Power BI Desktop file format that contains definitions for reports, data models, and queries, and it can be easily saved and tracked in a version-controlled environment. The solution should minimize development and maintenance effort, and saving in PBIX format allows for the easiest transition from development to deployment, especially when using Azure Pipelines for CI/CD (continuous integration/continuous deployment) practices.
References: The use of PBIX files with Power BI Desktop and Azure Repos for version control is discussed in Microsoft's official Power BI documentation, particularly in the sections covering Power BI Desktop files and Azure DevOps integration.
質問 # 116
......
検証済みDP-600日本語問題集と解答100%合格JPNTest:https://www.jpntest.com/shiken/DP-600J-mondaishu